
2026年,AI大模型正从通用对话走向代码生成、智能体协作等产业落地场景,模型代码能力的标准化评估需求也日益凸显。
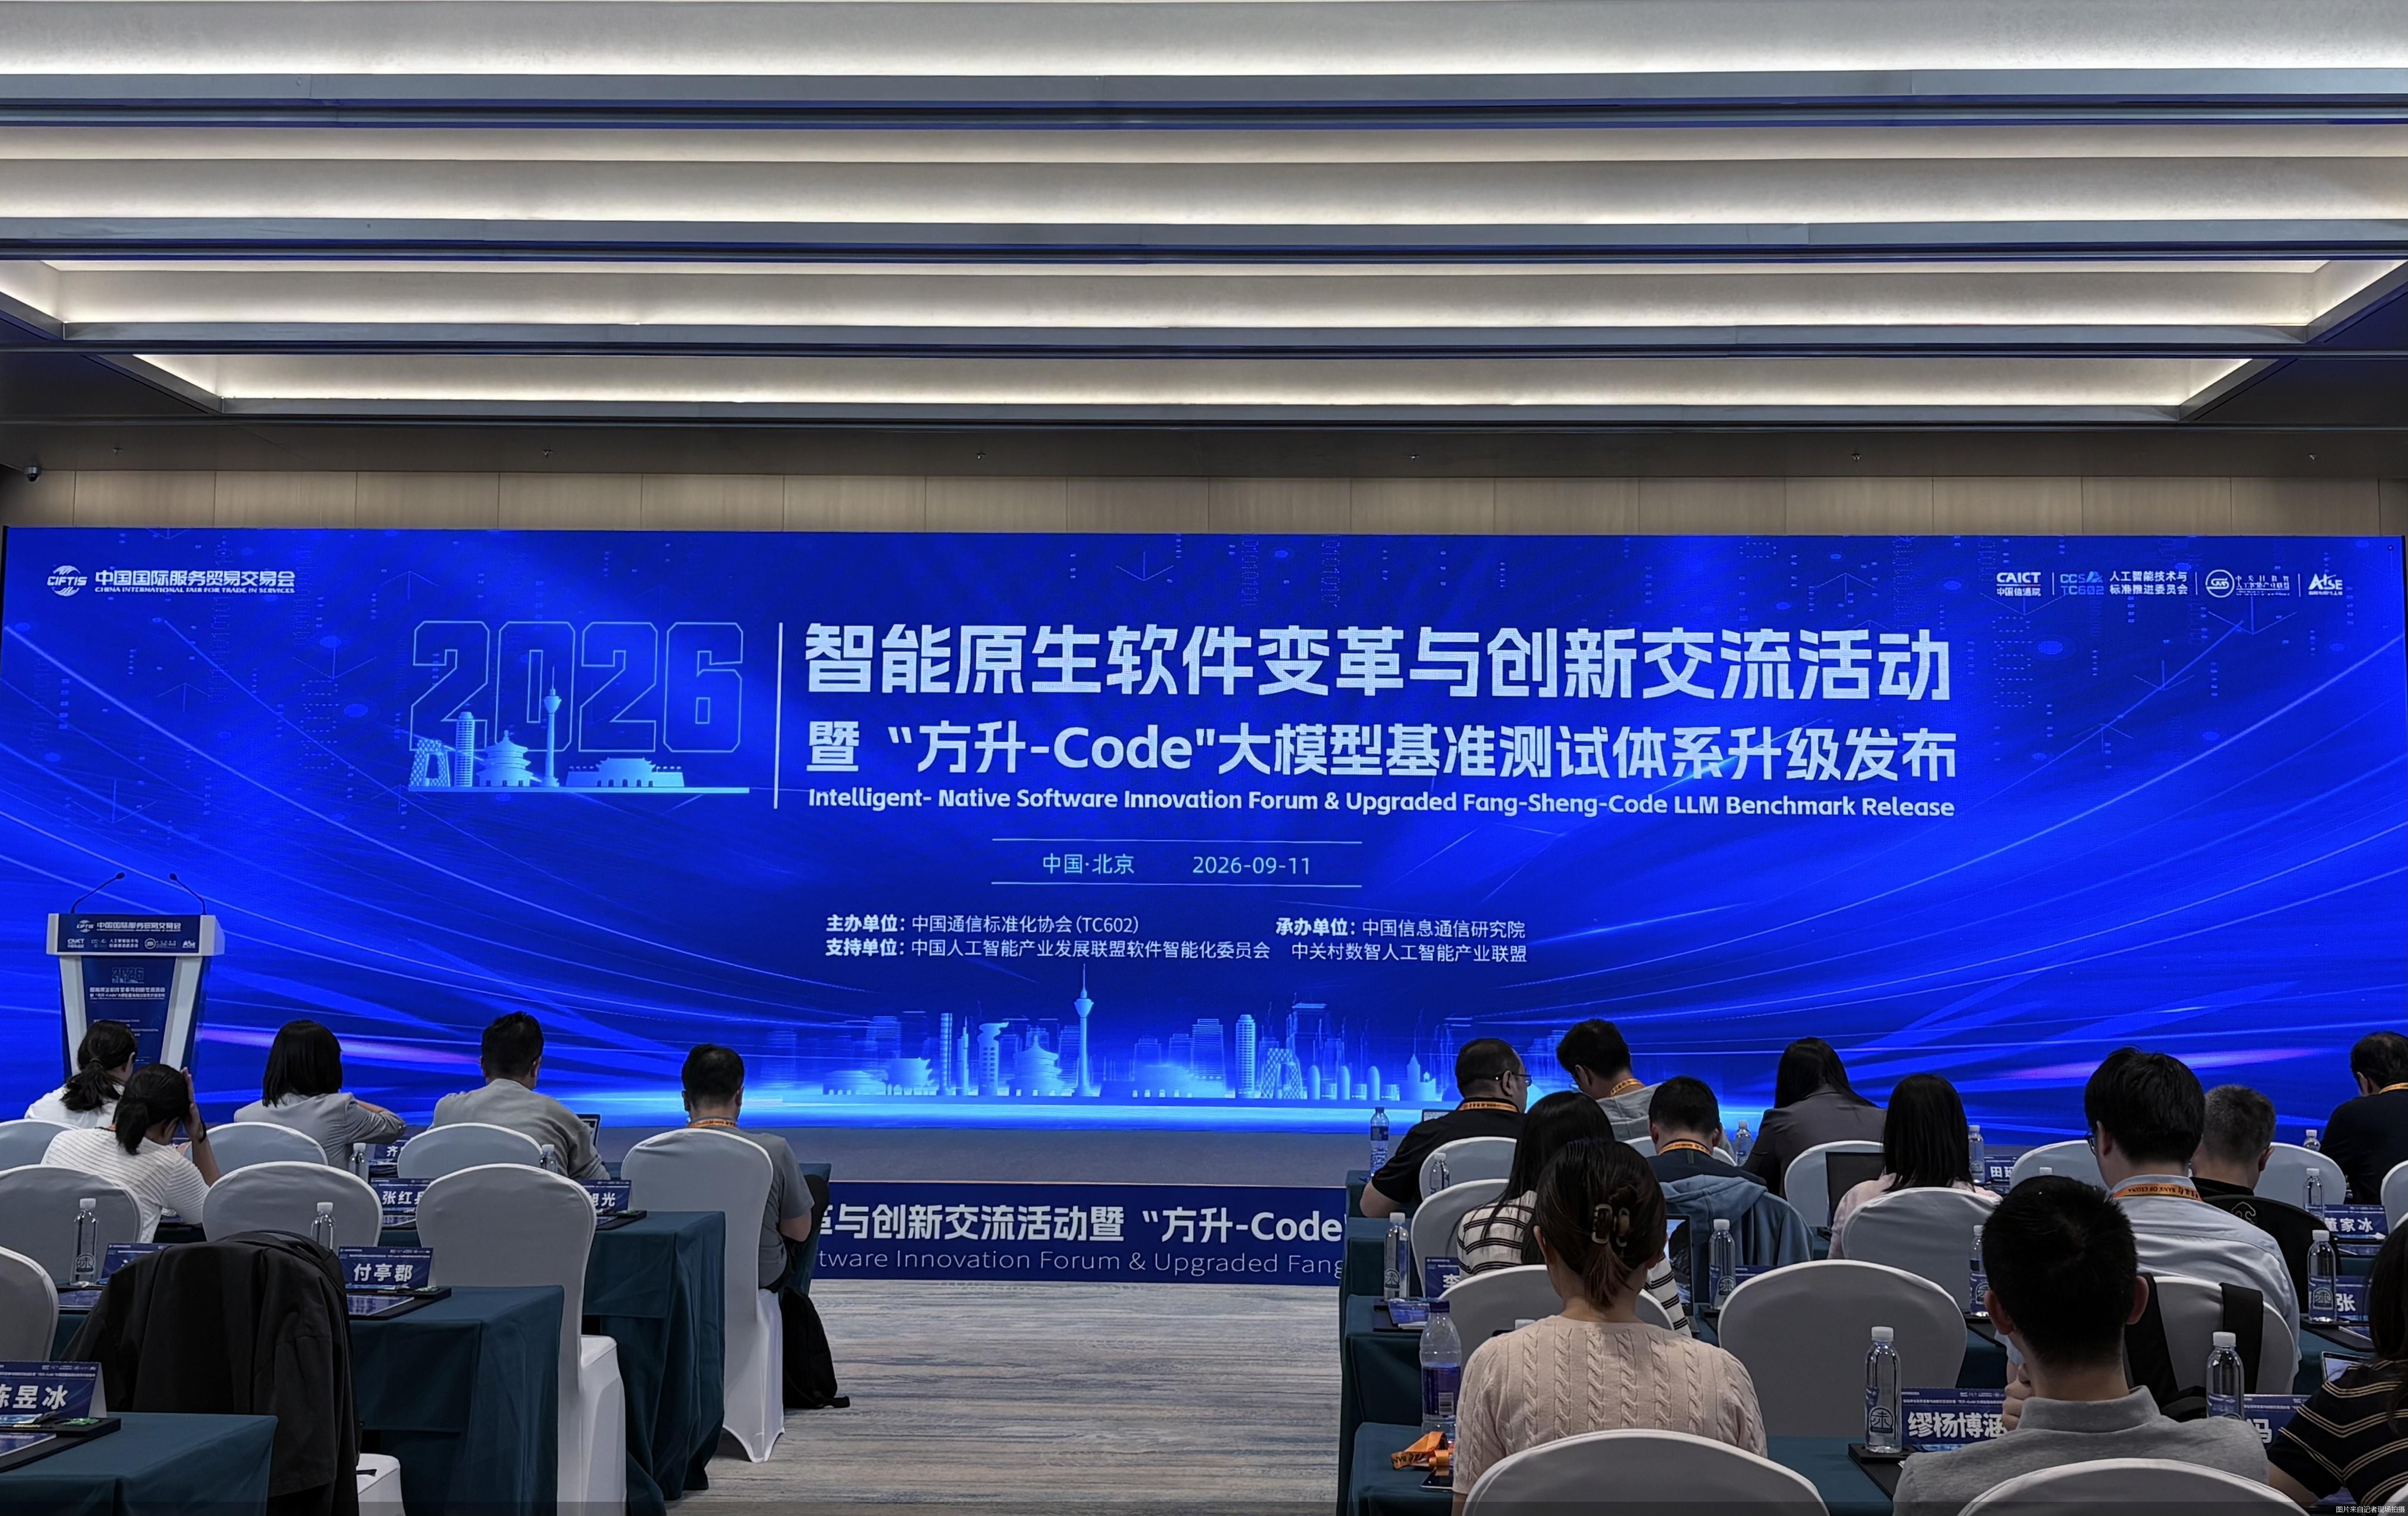
9月11日下午,中国信息通信研究院(以下简称“中国信通院”)在2026年中国国际服务贸易交易会(以下简称“服贸会”)智能原生软件变革与创新交流活动上,升级发布“方升-Code2.0”大模型基准测试体系。
“方升-Code”是中国信通院在工信部指导下研发的代码大模型基准测试体系。本次发布的2.0版,回应了当前AI代码评测体系在工程实践中暴露出的局限性。复旦大学计算与智能创新学院副院长、教授彭鑫指出,当前行业榜单繁荣,但很多评测集的初衷“是AI能力的练兵场,而非软件工程的试金石”,且存在评测任务偏简单、数据质量不高、验证标准单一、缺少科学难度分级等问题。
针对上述问题,中国信通院人工智能所平台与工程化部主任曹峰介绍了方升-Code的建设思路。他表示,方升-Code面向能力发现与生产部署需求,核心要求是构念清晰、任务真实、测量稳定和有效性验证,旨在刻画模型能力边界,支撑模型研发与应用部署选型。目前,方升-Code基准测试已构建5000余条高质量、多任务的评测数据,所有数据均来自真实的软件研发项目。本次测试选取代码生成、代码问题解决、单元测试、研发问答四类典型任务,动态选取高、中、低不同难度等级测试数据287条。
彭鑫进一步介绍,方升-Code 2.0从单一正确率转向多维综合测量,评测指标体系包括代码能力表现、工程质量与实际价值、效率成本分析、过程表现衡量、能力稳定性等。未来评测数据集将持续更新,并针对重点测评任务种类的高难度任务进一步开展精细化难度分级,加强被测模型和Agent(智能体)的能力识别区分度。
曹峰指出,评测范式正由“代码能否生成”走向“复杂工程任务能否持续、稳定完成”。大模型能力竞争焦点不是“一套题得分更高”,而是能否稳定完成更长、更复杂的真实研发任务。
工信部数据显示,2026年1-5月,我国软件业务收入约6.25万亿元,同比增长10.3%;截至6月,日均Token调用量已突破500万亿。
这一趋势也得到了政策层面的呼应。工业和信息化部近日印发的《“人工智能+软件”专项行动实施方案》提出,到2028年,累计组织实施100项软件企业智能化技改项目,在重点行业打造100个智能体软件标杆应用;到2030年,关键软件全面实现智能化升级,智能编程、智能体软件及智能服务等新业态成为产业新增长极。
中国信通院人工智能研究所平台与工程化部副主任秦思思在分享中指出,智能原生软件正推动软件从“提供功能”向“理解目标、规划任务并自主执行”演进,软件产品的测试也将更加关注智能任务执行与结果质量。
“下一步,中国信通院将携手产业各界,继续构建能够科学反映人工智能在软件行业应用真实情况的评测体系,为我国政策制定和产业落地提供准确参考。”中国信通院人工智能研究所所长魏凯说道。
北京商报记者 魏蔚 实习记者 鲁芹


本网站所有内容属北京商报社有限公司,未经许可不得转载。 商报总机:010-64101978 版权合作:010-64101871
商报地址:北京市朝阳区和平里西街21号 邮编:100013 法律顾问:北京市中同律师事务所(010-82011988)

 网上有害信息举报 违法和不良信息举报电话:010-84276691 举报邮箱:bjsb@bbtnews.com.cn
ICP备案编号:京ICP备08003726号-1  京公网安备11010502045556号 互联网新闻信息服务许可证11120220001号


